관리자 글쓰기
법인세 - 익금 (1)
2021. 8. 3. 13:19 - MunJunHyeok

1. 익금

 익금은 세법에서 예시주의로 적용한다. 포괄주의라고도 하며, 순자산이 증가하는 경우 익금으로 본다. 반면 순자산이 증가하여도 익금으로 보지 않는 경우가 있는데, 이를 익금불산입 항목으로 하여 열거주의로 열거되어있다.


 (1) 현금 증가의 경우 (현금 또한 자산이나 이해를 돕기위해 분리한다.)

  ㄱ. 사업수입금액 (매출)


  ㄴ. 자산의 양도가액 (재고자산 외의 모든 자산을 의미한다)


  ㄷ. 자산의 임대료


  ㄹ. 손금에 산입되었던 금액의 환입액


  ㅁ. 간접외국납부세액 (순자산이 증가하지 않았지만 익금으로 간주한다)

   : 법인이 아닌 법인의 자회사가 외국에 납부한 세액을 의미한다.

    ▶ why? 고의로 이중과세로 만들어 이후 세액공제해주기 위해서.


  ㅂ. 임대보증금 간주임대료. 

   : 내국영리법인이면서, 부동산임대업이 주업(보유 부동산의 50% 이상이 세)이고 차입금이 과다한 법인일 경우(차입금

   이 자본의 2배 이상) 임대보증금은 순자산의 증가가 아님에도 불구하고 임대료로 간주하여 익금으로 본다.

   ▶ why? 보증금을 이용하여 투자하고 그 투자 수익을 장부에 적절하게 반영하지 않는 경우가 있기 때문이다.


   이 때 익금으로 간주하는 금액을 구하는 산식은 다음과 같다.

   ◈ 일반 (기장 O) :

     {(보증금 - 건설비) * 이자율 - 금융수익 = 익금 금액 (익금산입, 기타사외유출)

   ◈ 추계시 (기장 X, 상기 요건 없이 모든 법인 대상) :

     보증금 * 이자율 = 익금 금액 (불가항력 사유 시 기타사외유출. 그 외 대표자 상여)


 (2) 자산 증가의 경우

  ㄱ. 자산수증이익 (자산을 받아서 생긴 이익)

   : 'A 법인'의 재무상태표 상의 이익이 100억 잡혀있다고 가정하자. 그렇다면 아무런 문제가 되지 않는다. 회계에서 인

   정하는 이익이 100억이며, 법인세법에서 인정하는 소득 또한 100억이기 때문에 세무조정이 필요하지 않다. 

    회계에서 자산수증이익을 이익으로 인정하지 않아 'A 법인'의 재무상태표에 이익이 하나도 잡혀있지 않다고 가정하

   자. 그러나, 법인세법에서는 자산수증이익을 익금으로 보고 있기 때문에 소득이 100억으로 신고되어야한다. 따라서

   익금산입의 세무조정사항이 발생하여 100억의 유보 처분이 발생하며, 세무조정이 이루어진다.


   ㄴ. 자산의 평가이익

    : 보험업법 그 밖의 법률규정에 따라 평가이익을 익금 산입해야하는 경우에는 익금으로 인정한다. 그러나, 그 외의 법

    인이 임의로 평가증한 금액은 익금으로 인정하지 않는다.


   ㄷ. 유가증권의 저가양수 (부당행위계산부인. 순자산이 증가하지 않았음에도 익금으로 간주한다.

    : 일반적인 저가양수의 경우, 저가로 양수하여도 처분 시에는 제 값을 받아 그 차액만큼 과세가 되므로 저가로 양도

    한 자에게만 그 양도한 자산의 시가저가로 양도한 금액의 차액만큼 익금 산입한다.

    그러나, '특수관계''개인''유가증권'저가양수하는 경우에 한하여 양수한 자에게 그 차액을 익금 산입한다. 대

    신 처분 시에 저가로 양도한 금액과 처분한 금액의 차이가 아닌, 시가와 처분한 금액의 차이만큼만 과세한다.

    ▶why? 양도한 자가 소액주주인 개인이라면, 장내 거래했을 때 비과세 되기 때문이다.


   ㅁ. 불공정자본거래익 (순자산이 증가하지 않았음에도 익금으로 간주한다.)

    : 본래 일반적인 자본거래(합병, 증자, 감자 등)는 순자산이 증가하지 않아 익금으로 보지 않지만, 이러한 자본거래가

   불공정하다고 판단되는 경우에는(주로 특수관계가 있는 경우이다) 익금으로 본다.


(1) 배당소득의 이중과세 문제

 'A법인' 이라는 법인에서 올해 100원의 총수입금액을 벌어들였다고 가정하자. 그리고 'A법인'은 총수입금액 中 10%인 10원을 법인세납부한다. 그리고 남은 금액인 90원'甲 개인'에게 배당으로 지급될 것이다. 이때, '甲 개인'은 이 때 받은 배당소득에 대해서 종합과세된다. 결론적으로, '甲 개인'이 받은 배당금은 법인세 1번, 종합소득세 1번 총 2번 과세되는 것이다. 이를 이중과세라고 하며 일반적으로 옳지 못한 과세로 판단되므로 조정이 필요하게 된다. 대한민국에서는 이러한 이중과세를 조정하기 위하여 Gross-up 제도를 이용한다.


(2) Gross-up (이하 G-up) 제도

 'A 법인'이 법인세를 납부한 후의 90원에 대하여 G-up을 적용할 경우에 다음과 같이 된다.

1. 배당소득 90원에 11%의 G-up 금액을 곱하면 약 10원 정도의 금액이 나온다.

2. 배당소득 90원과 G-up 금액 10원을 합하여 100원을 만든 뒤,
그 합한 금액인 100원에 종합소득세기본세율(10%로 가정한다) 을 적용하여 산출세액인 10원을 구한다.

3. 이 산출세액 10원에서 G-up 금액인 10원을 배당세액공제로 제한다.

4. 따라서 종합소득세에서 '甲 개인'은 배당소득으로 인해 과세되는 금액은 0이 된다.


 상기 예시에서는 기본세율을 10%로 가정하여 종합소득세가 0이 되었으나, 실제로는 더 높은 경우가 대부분이다. 또한 법인세는 10%에서 25%까지의 구간으로 나뉘어있지만, G-up 금액을 구할 때는 11%로 고정된 금액을 적용하므로 10% 이상의 법인세율을 적용받는 법인의 경우 이중과세문제를 여전히 감수하고 있다는 단점이 있다. 따라서 G-up 제도는 이중과세 문제를 100% 조정해주는 제도가 아니다. 


(3) G-up 적용 조건

 1. 내국법인으로부터 지급된 배당이어야 한다. 

  ▶ 즉, 법인세가 과세된 배당이어야 한다.

 2. 피투자회사에서 과세된 소득을 재원으로 해야한다.

  ▶ 즉, 집합투자기구 등 비과세 감면된 소득아니어야한다.

 3. 기본세율을 적용받는 종합과세배당소득이어야 한다.

  ▶ 즉, 연 2천만원 이하 원천징수세율(14%)의 적용받지 않아야 한다.

 Algorithm. 알고리즘은 간단하게 얘기하면 문제를 해결하는 절차이자, 문제의 처리 방법을 체계적으로 기술한 것입니다.

알고리즘은 궁극적으로 컴퓨터가 효율적으로 문제를 해결하도록 최적의 프로그램을 작성하는 것이 목표입니다.


 프로그램이란 실제 세계를 컴퓨터가 이해할 수 있는 형태로 매핑한 것을 의미합니다. 예를들어 '줄을 서 있는 사람들'을 컴퓨터 내에서 '대기열'로 표현할 수 있습니다. 이를 추상화라고 합니다.


 추상화(abstraction)는 문제 해결을 위해 복잡한 문제를 단순화 시키고, 다른 문제에도 적용할 수 있게 하는 것입니다. 여기서 추상 자료형(ADT)이라는 개념이 나옵니다. 어떠한 자료의 특성을 논리적으로 추상화하여 정의한 자료형을 추상 자료형이라고 합니다. 이렇게 얘기하면 복잡할 수 있지만 쉽게 예를 들 수 있습니다.


 '정수'라는 것은 소숫점 이하 자리수 없이 표현되는 숫자입니다. 이 숫자는 늘어나기도 (+) 줄어들기도 (-) 합니다. 이는 실생활에서 사람의 수나 물건의 개수가 늘어나고 줄어드는 것에 대한 추상화입니다.


 알고리즘은 앞서 얘기했듯, 최적의 프로그램을 작성하는 것이 목표입니다. 그리고 프로그램은 실제 세계를 컴퓨터가 이해할 수 있는 형태로 바꾼 것(추상화)입니다. 즉, 알고리즘을 공부한다는 것은 이미 많은 사람들이 만들어놓은 추상 자료형을 이해하고, 새로운 문제 해결을 위하여 기존 추상 자료형을 조합하여 새로운 추상 자료형을 정의할 수 있는 능력을 확보하는 것입니다.

 좋은 소프트웨어란 무엇일까? 보통 사용하기 편리하고, 보기 깔끔하고, 원하는 기능이 모두 포함되어 있는 소프트웨어를 떠올린다. 그리고 아주 틀리지 않았다. 대신 소프트웨어공학에서는 확실한 개념을 제시할 뿐이다. 소프트웨어공학에서 말하는 좋은 소프트웨어의 조건으로는 수용성. 의존성. 효율성. 유지보수성. 4가지를 제시한다.


 먼저 수용성은, 소프트웨어를 사용하는 사용자가 소프트웨어에 대해 이해하기 쉽고, 소프트웨어를 사용하기 쉽고, 사용자가 사용하는 다른 시스템과 호환이 가능할 때 수용성이 높다고 한다.


 의존성이 높다는 말은, 좀 더 쉽게 말하면 신뢰성/보안성/안정성을 확보했다는 의미다. 시스템과 소프트웨어의 일부에서 실패가 발생하더라도, 전체 시스템에 대한 물리적/경제적 피해가 없거나 적다는 뜻이다.


 효율성은, 소프트웨어의 응답/처리 시간이 빠르며 적은 자원으로 최대의 성능을 낼때 그리고 시스템 자원의 낭비가 없을 때 효율성이 높다고 한다.


 유지보수성은, 소프트웨어가 작성되기 이전이나 이후에, 변화하는 고객의 요구사항을 충족시킬 수 있는지 여부를 의미한다.


그리고 추가적으로 소프트웨어가 일반적인 사용자를 대상으로 할 때엔 Generic한 소프트웨어(예: 워드, 포토샵 등),

특정 사용자를 대상으로 할 때엔 Customized 된 소프트웨어(예: 특정 대학 학생들의 개인 사이트, 공항의 관제 시스템 등)라고 한다.

1. 소프트웨어 = 코딩 인가?

 소프트웨어는 project 도중 만들어지는 documents들도 포함된다. 소프트웨어가 필요한 요구사항들을 정리해둔 문서, 설계 방향에 대한 문서, 어떤 class를 이용해 어떤 method를 만들 것인지에 대한 아주 상세한 문서까지.


2. 좋은 소프트웨어가 가져야 할 조건은 무엇인가?

  기능 · 성능 · 유지보수의 용이성 · 의존성 · 사용의 용이성


3. 소프트웨어 공학이란?

 소프트웨어 생산과 관련된 모든 공학적 원리를 다루는 학문. 시스템 공학의 일부이다.


4. 소프트웨어 공학의 주요 과제는?

 다양성, 개발 시간 단축, 신뢰성 있는 소프트웨어 개발


5. 최고의 소프트웨어 공학 기술은?

 없다. 어떤 시스템을 개발하는가에 따라 다양한 기술 및 방법론이 사용된다.

[mySQL] substring 함수, 그 외의 함수.
2020. 2. 5. 15:40 - MunJunHyeok

저번 게시글에서 sampleDB를 이용해 집계함수의 사용에 대해 살펴보았습니다.


Sample DB 설정 방법은 다음 링크를 참조하세요. (https://m-datastudy.tistory.com/5)


이번에는 마찬가지로 SELECT ~ FROM 쿼리(구문)에 사용할 수 있는 집계함수 외의 함수를 알아볼것입니다. 저번 게시물 (https://m-datastudy.tistory.com/10)를 보신 분들은 이제 레코드의 개수나 숫자로 된 레코드 값의 합, 평균 등을 알아볼 수 있고, 특정 기준에 따라 레코드를 묶을 수도 있습니다. 


먼저 함수는 저번과 이번 게시물에 적힌 것보다 훨씬 많습니다. 지금 쓰려는 것은 그 중 기본적이라고 생각되는 함수인것입니다.


1. SUBSTRING('문자열' , offset, limit) 

SUBSTRING 함수는 문자열에서 원하는 부분만 뽑아내는 함수입니다.

FROM 구문이 반드시 필요하지는 않습니다. 다음과 같이 사용합니다.

-> SELECT SUBSTRING('문자열' , offset, limit);

-> SELECT SUBSTRING('2019-03-19' , 6, 2);


또한 모든 함수는 반드시 정해진 인자에 맞춰서 사용해야만 합니다. 인자란 ('문자열', offset, limit)의 부분을 의미합니다.


1. '문자열' 부분은 우리가 뽑아내고싶은 글자가 있는 문장이나 긴 텍스트를 넣습니다.


2. offset 부분은 저번에 살펴보았던 LIMIT~OFFSET~ 구문처럼 어디서 부터 텍스트를 뽑아낼 것인지 숫자로 정합니다.

예를 들어 '2019-03-19' 문자열에서 첫번째 글자인 '2'가 1번째 글자이고 '0'이 2번째, '1'이 3번째, '9'가 4번째 글자입니다.


3. limit 부분은 몇글자를 뽑아낼지 정합니다.


정리하자면, SELECT SUBSTRING('2019-03-19' , 6, 2); 쿼리는 '2019-03-19'라는 문장의 6번째 글자부터 2글자를 찾아 출력하라는 뜻입니다. 결과값은 '03'이 됩니다. 작은 따옴표 안의 모든 글이 텍스트입니다. 따라서 ' - ' 또한 텍스트입니다.


2. TRIM('문자열')


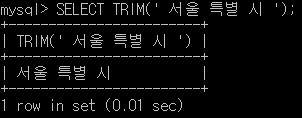
TRIM 함수는 문자열 앞 뒤에 있는 공백을 제거합니다. ' 서울특별시 '를 함수 처리 할 경우 '서울특별시'로 출력됩니다.

단, 문자 내부의 공백은 제거되지 않습니다. substring처럼 반드시 FROM이 필요하지는 않습니다.

-> SELECT TRIM(' 문자열 ');


앞 뒤의 공백만 제거된다.


3. CHAR_LENGTH('문자열'), OCTET_LENGTH('문자열')


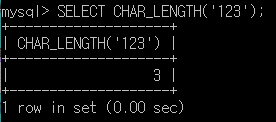
CHAR_LENGTH 함수는 문자열의 길이. 즉, 글자수를 알려주는 함수입니다. 다음과 같이 사용합니다.

-> SELECT CHAR_LENGTH('문자열');

-> SELECT CHAR_LENGTH('123');


123 문자열은 3글자이다. 한글도 사용 가능하다.

OCTET_LENGTH 함수는 문자열의 byte 수. 즉, 용량을 알려주는 함수입니다.

일반적으로 문자 하나 당 숫자 및 영어는 1byte. 한글은 2byte입니다. 다음과 같이 사용합니다.

-> SELECT OCTET_LENGTH('문자열');

-> SELECT OCTET_LENGTH('123abc가나다');

123(숫자, 3byte) + abc(영어, 3byte) + 가나다(한글 6byte)로 모두 합해 12 byte입니다.


4. ROUND(컬럼명/숫자, 반올림위치)


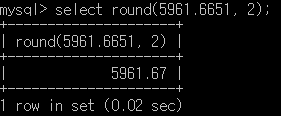
ROUND 함수는 반올림해주는 함수입니다. 어느 위치에서 반올림 할 지도 직접 정할 수 있습니다. 

mySQL에서는 2가 소숫점 둘째 자리로 반올림해줍니다. 1이 첫째 짜리로, -1이 1의 자리, -2가 10의 자리로 반올림해주는 식입니다. 소숫점 둘째 자리에서 반올림 해주는 것이 아니라 결과값이 소숫점 둘째자리로 출력됩니다.

-> SELECT ROUND(컬럼명/숫자, 반올림 위치);

-> SELECT ROUND(컬럼명, 2) FROM 테이블명;

-> SELECT ROUND(5961.6651, 2);


컬럼명이 들어갈 경우 컬럼의 숫자가 반올림 됩니다. 컬럼명 일 경우 FROM이 필요하고, 숫자형이어야 합니다.


5. CONCAT('문자열1'/컬럼명, '문자열2'/컬럼명)


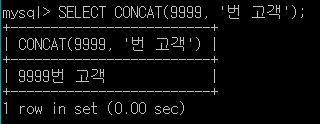
CONCAT 함수는 여러개의 문자열을 합칠 수 있는 함수입니다. 앞 뒤 글자가 합쳐집니다. 컬럼명일 경우엔 자료형이 숫자형 혹은 문자형이어야 합니다. 


컬럼명 + 문자열도 가능합니다. 예를 들어,

-> SELECT CONCAT(customerNumber, '번 고객') FROM customers;

일 경우에, 컬럼 내의 모든 레코드의 뒤에 '번 고객'이 합쳐져 출력됩니다.


컬럼명 + 문자열의 조합


문자열 + 문자열의 조합


[mySQL] 집계함수: COUNT, SUM, AVG, GROUP BY
2020. 2. 4. 16:06 - MunJunHyeok

저번 게시글에서 sampleDB를 이용해 WHERE 구의 사용과 연산자 등에 대해 살펴보았습니다.


Sample DB 설정 방법은 다음 링크를 참조하세요. (https://m-datastudy.tistory.com/5)


이번에는 SELECT ~ FROM 쿼리(구문)에 사용할 수 있는 여러가지 함수를 알아볼것입니다. 저번 게시물 (https://m-datastudy.tistory.com/9)를 보신 분들은 이제 원하는 조건을 지정해서 테이블로부터 레코드를 불러 올 수 있습니다. 

그런데 만약 레코드의 개수가 엄청나게 많아서 개수조차 세기 힘들 때에는 어떻게 해야 할까요?


그럴 때는 집계함수를 이용해 한 컬럼 내의 레코드의 개수를 세거나 합과 산술평균 등을 낼 수 있습니다. 


1. 집계함수 : COUNT(개수), SUM(총합), AVG(평균), GROUP BY(묶음)


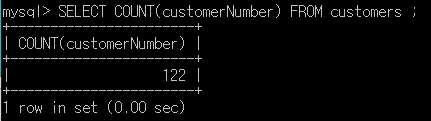
◈ COUNT 함수는 컬럼내 레코드의 개수를 세주는 함수로 다음과 같이 사용합니다.

-> SELECT COUNT(컬럼명1) FROM 테이블명;

-> SELECT COUNT(컬럼명1), COUNT(컬럼명2), ... FROM 테이블명;

다음은 예시입니다.

customerNumber의 레코드 개수는 122개이다.

COUNT 함수는 레코드의 자료형에 상관없이 사용할 수 있습니다. 

다만 특별한 경우를 제외하면, 집계함수일반 컬럼을 함께 사용할 경우 오류가 발생합니다.

즉, 다음과 같은 경우에는 오류가 발생합니다.

-> SELECT COUNT(customerNumber), customerNumber FROM customers; 


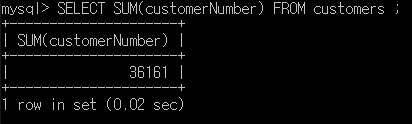
◈ SUM 함수는 컬럼 내 레코드 값의 총합을 내주는 함수입니다.

다음과 같이 사용합니다.

-> SELECT SUM(컬럼명1) FROM 테이블명;

-> SELECT SUM(컬럼명1), SUM(컬럼명2), ... FROM 테이블명;

다음은 예시입니다.

customerNumber의 총 합은 36,161이다. 물론 고객번호를 더해봤자 의미있는 숫자가 나오는 것은 아니다. 어디까지나 연습용임을 잊지말자.

SUM 함수는 컬럼의 자료형이 숫자형일때만 사용할 수 있습니다. 

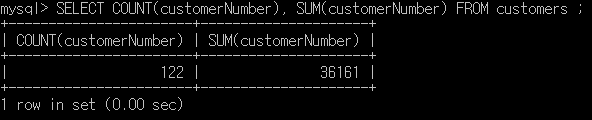
그리고 같은 집계함수끼리는 다음과 같이 함께 사용할 수 있습니다.


위와 달리 집계함수가 사용되지 않은 컬럼이 함께 쿼리로 작성될 시엔 오류가 발생한다.


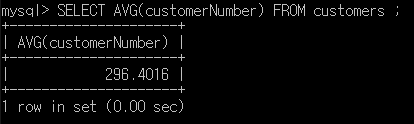
◈ AVG 함수는 컬럼 내 레코드 값의 평균을 구해줍니다. 

다음과 같이 사용합니다.

-> SELECT AVG(컬럼명1) FROM 테이블명;

-> SELECT AVG(컬럼명1), AVG(컬럼명2), ... FROM 테이블명;

다음은 예시입니다.

customerNumber의 평균은 296.4016이다.

마찬가지로 AVG 함수는 컬럼의 자료형이 수치형일 때만 사용할 수 있습니다.


◈ GROUP BY 함수는 종류가 같은 것들이 하나로 묶입니다.

GROUP BY는 쿼리(구문)의 가장 마지막에 사용합니다. 기준을 제시하면, 그 기준에 따라 모아줍니다.

말로 설명하면 이해하기 힘들 수 있으므로 예시로 확인하겠습니다.


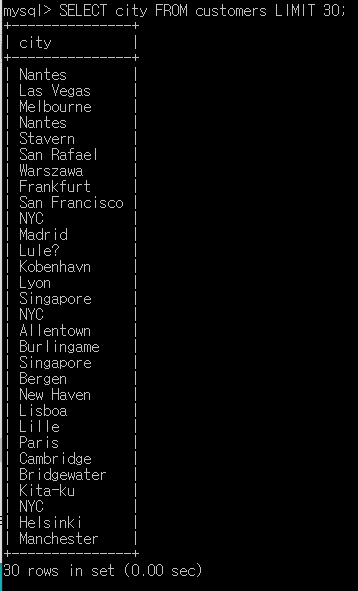
customers 테이블에서 city 컬럼만 불러와 30개의 레코드만 출력합니다.

도시가 중복되는 것이 있는데 같은 도시가 여러번 나오기도 하고 중구난방으로 배열되어있어서 알아보기 힘듭니다.


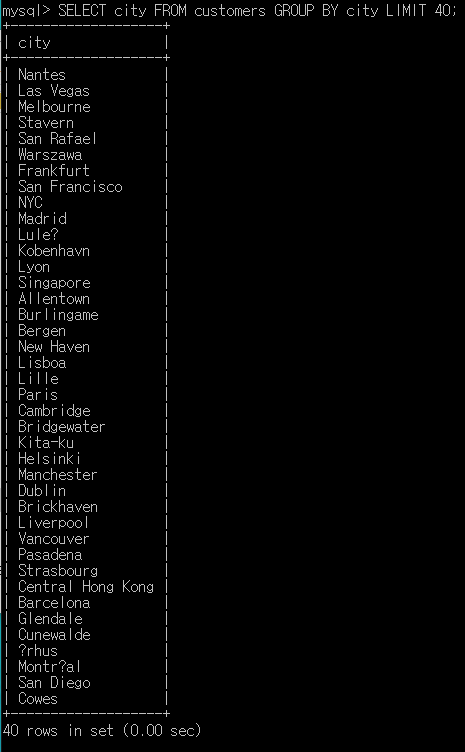
그때 GROUP BY를 사용하면 더 보기 편해집니다. 중복되는 데이터는 하나로 모아줍니다.


그럼 다음과 같이 테이블 내에 표시된 모든 도시의 종류를 한번에 볼 수 있습니다.


중복되는 도시를 제외하고 각 도시를 하나씩만 보여줍니다.

GROUP BY 함수는 자료형 상관없이 사용할 수 있습니다. 


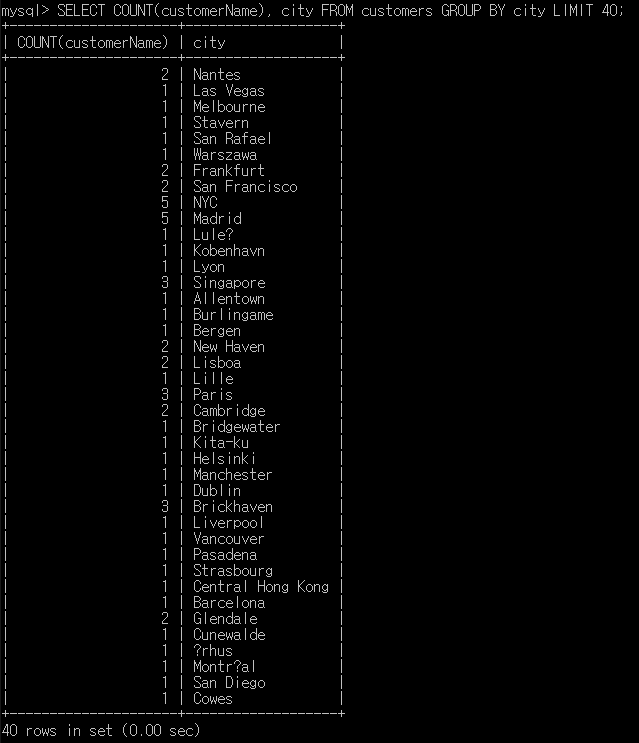
그리고 다른 집계함수와 연계하여 사용하면 그 진가를 발휘합니다.


어떤 도시에 몇 명의 고객이 있는지 한눈에 파악할 수 있다.

예외적으로 GROUP BY 함수에 기준으로 제시된 컬럼은 위와 같이 집계함수와 함께 사용될 수 있습니다.


또한 중요한 것으로 모든 집계함수는 WHERE구와 함께 사용할 수 없고, 대신 HAVING 구를 사용하여 조건식을 지정할 수 있습니다.

구문이 처리되는 순서는 GROUP BY -> SELECT -> ORDER BY 순으로 처리됩니다.


[mySQL] SELECT 구문의 확장. WHERE .
2020. 1. 17. 14:45 - MunJunHyeok

저번 게시글에서 sampleDB와 SELECT 예약어(SELECT, FROM, * 등의 구문을 예약어라고 합니다)를 이용해 간단한 테이블을 불러오고, 테이블에 대한 정보를 확인하는 법을 살펴보았습니다.


Sample DB 설정 방법은 다음 링크를 참조하세요. (https://m-datastudy.tistory.com/5)


이번에는 SELECT~FROM 예약어를 더 활용해보겠습니다. 저번 게시물 (https://m-datastudy.tistory.com/6?category=856604)를 보신 분들은 이제 테이블의 컬럼을 지정해서 불러올 수 있습니다. 그렇다면 컬럼 내에서 원하는 데이터를 선택하려면 어떻게 해야 할까요?


1. WHERE 구에서 레코드(row) 지정하기.

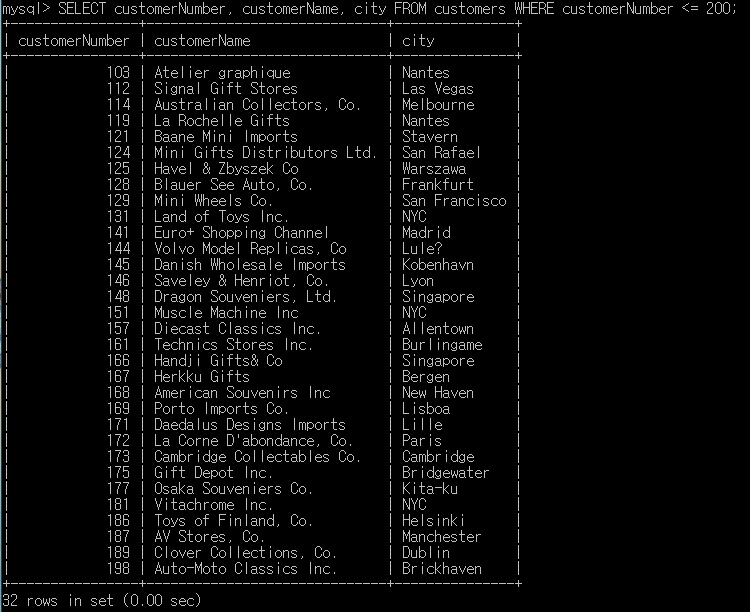
다음은 customer라는 테이블에서 customerNumber, customerName, city 컬럼을 불러오고, 그 중 customerNumber가 200 이하인 고객의 정보만 불러오는 명령입니다.


다음과 같이 WHERE 구는 컬럼에 조건을 설정해 특정 데이터만을 불러 올 수 있게 해줍니다. WHERE 구를 사용하기 위해서는 먼저 알아야 하는 것이 데이터의 자료형과 연산자 입니다.


2. 데이터의 자료형과 연산자.


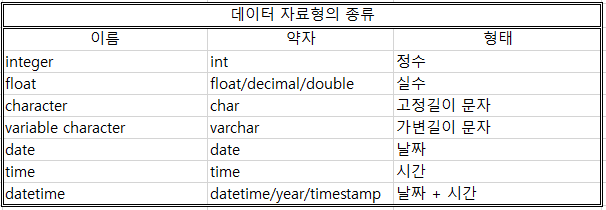
일상생활에선 글을 쓸 때 한 페이지에 숫자이든, 글자이든 그저 손으로 적으면 됩니다. 하지만 컴퓨터는 이런 작업을 할 수 없습니다. 한 페이지마다 숫자를 사용할지, 글자를 사용할지, 숫자나 글자를 몇개 넣을지, 아니면 숫자나 글자를 같이 사용할지 등을 따로 정한 뒤에 써야합니다. 가장 많이 사용되는 자료형은 다음과 같습니다.

저번 게시글에서 desc 명령어를 통해 테이블의 구조를 살펴보았습니다. 그때 이미 int와 varchar는 본 적이 있습니다. char와 varchar의 차이는 char는 정확히 입력한 용량만큼 글자가 들어가야합니다. 더 적거나 많아도 안됩니다. varchar는 이러한 제약으로부터 자유롭습니다. 대신 char보다 컴퓨터의 처리속도를 더 많이 깎아먹게 됩니다.


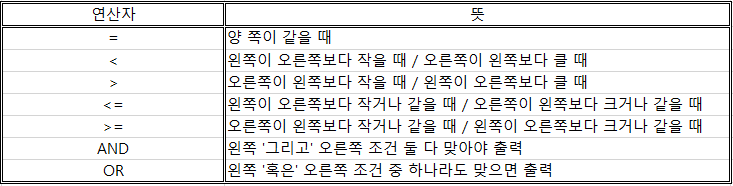
다음은 비교연산자입니다. 이러한 비교연산자들은 다른 코딩 프로그램에서도 거의 같게 사용됩니다.


테이블이나 컬럼의 자료형이 문자형일 때는 =, <, >, <=, >= 연산자는 사용할 수 없음에 유의해주세요.


3. (추가) 출력 레코드의 제한. LIMIT ~ OFFSET ~

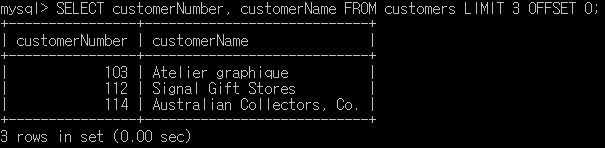
LMIT ~ OFFSET ~ 구문을 이용해 출력할 레코드의 수를 조정할 수 있습니다.


offset 0 (0번째 줄부터) limit 3 (3줄만)

LIMIT은 출력할 레코드의 개수를 지정하는 것입니다.

OFFSET은 어느 레코드부터 개수를 지정할지 정하는 것입니다.


[Practice] Web Crawling 특강 정리
2019. 12. 21. 18:42 - MunJunHyeok
Seminar note

2019년 11월 26일 명지대학교에서 진행된 박찬엽 (현) 코빗 재무팀 데이터 담당자(https://mrchypark.github.io) 님의 웹 크롤링 특강 중, 간단한 웹크롤링 방법을 정리합니다.

# txt를 긁어올 링크를 tar변수에 저장.
tar <- "https://news.naver.com/main/read.nhn?mode=LSD&mid=shm&sid1=100&oid=005&aid=0001262837"
# 서버에 data 요청 후 html 문서화.
read_html(tar) %>% 
 html_nodes("h3#articleTitle") %>%
 html_text()
## [1] "지소미아 발표 후 日대사관 “죄송하다… 이건 정무차관 메시지”"


# 전문을 긁어오지만 html코드등이 포함되어 다른 방식으로 처리해야함.
read_html(tar) %>%
  html_nodes("div#articleBodyContents") %>%
  as.character()
## [1] "<div id=\"articleBodyContents\" class=\"_article_body_contents\">\n\t<!-- 본문 내용 -->\n\t<!-- TV플레이어 -->\n\n<!-- // TV플레이어 -->\n<script type=\"text/javascript\">\n// flash 오류를 우회하기 위한 함수 추가\nfunction _flash_removeCallback() {}\n</script><span class=\"end_photo_org\"><img src=\"https://imgnews.pstatic.net/image/005/2019/11/26/611112110013969135_1_20191126141804901.jpg?type=w647\" alt=\"\"></span><br><br>일본 정부가 한일 군사정보보호협정(GSOMIA·지소미아) 조건부 종료 연기 결정에 대한 양국 합의내용을 실제와 달리 발표한 데 대해 외무성 차관의 사과 메시지를 한국 측에 전달했던 것으로 확인됐다. 또 우리 정부가 일본 측 발표내용이 실제와 다르다고 공개적으로 반박한 데 대해 일본 정부는 아직까지 우리 정부에 공식 항의하지 않은 것으로 전해졌다.<br><br>26일 복수의 정부 관계자에 따르면, 지소미아 조건부 종료 연기 결정이 양국에서 발표된 22일 오후 9시가 넘은 시각 외교부는 주한일본대사관 정무공사를 불러 들였다. 이날 오후 6시 우리 정부의 지소미아 조건부 종료 연기 결정 직후 일본 경제산업성(경산성)이 ‘반도체 관련 3개 품목 수출 규제 및 화이트리스트 제외 조치에 당장 변화는 없다’고 발표한 데 대해 항의하고자 한 것이었다.<br><br>일본 발표 전 청와대 고위관계자는 기자들에게 ‘현안 해결에 기여하도록 국장급 대화를 해 양국 수출관리를 상호 확인한다’ ‘한일 간 건전한 수출실적 축적 및 한국 측의 적정한 수출관리 운용을 위해 (규제대상 품목 관련) 재검토가 가능해진다’ 등의 내용이 담길 것이라고 설명했다.<br><br>외교부는 이같은 양국간 합의 내용과 다르게 일본 정부 입장이 보도된 데 대해 강하게 문제를 제기했다고 한다. 이에 일본 대사관 정무공사는 경산성의 발표에 대해 ‘죄송하다’는 표현과 함께 사과를 하면서 이는 정무공사 개인의 입장이 아니라 일본 외무성 차관의 메시지라고 밝혔다는 것이 정부 관계자들의 설명이다.<br><br>일본 정부가 이렇게 사과의 뜻을 밝혔음에도 24일 아베 신조(安倍晋三) 일본 총리는 ‘일본은 아무것도 양보하지 않았다’고 말했다. 이에 청와대는 “그 발언이 사실이면 지극히 실망”이라면서 “일본 정부 지도자로서 과연 양심을 갖고 할 수 있는 말인지 되묻지 않을 수 없다”고 강하게 비판했다.<br><br>정의용 청와대 국가안보실장도 나서 일본 측이 ‘한국이 지적한 입장을 이해한다’면서 ‘경산성에서 부풀린 내용으로 발표한 데 대해 사과한다’고 밝혔다고 전했다. 논란이 계속되자 25일에는 윤도한 청와대 국민소통수석은 서면브리핑을 통해 “일본 측은 분명히 사과했다”며 “일본 측이 사과한 적이 없다면 공식 루트를 통해 항의해 올 것”이라고 재차 강조했다.<br><br>이같은 청와대 반응에 대해 26일 현재 일본 정부로부터 공식적으로 항의가 들어온 것은 없는 것으로 알려졌다.<br><br>김남중 기자 njkim@kmib.co.kr<br><br><b><a href=\"http://naver.me/GxmvUNz3\" target=\"_blank\"><font color=\"f98b10\">[국민일보 채널 구독하기]</font></a></b><br><b><a href=\"https://m.post.naver.com/my.nhn?memberNo=12282441\" target=\"_blank\"><font color=\"f98b10\">[취향저격 뉴스는 여기]</font></a> <a href=\"https://www.youtube.com/channel/UCb-AbqZutk9nTlJLZRcBinw\" target=\"_blank\"><font color=\"f98b10\">[의뢰하세요 취재대행소 왱]</font></a></b><br><br>GoodNews paper ⓒ <a href=\"http://www.kmib.co.kr\" target=\"_blank\">국민일보(www.kmib.co.kr)</a>, 무단전재 및 재배포금지\n\t<!-- // 본문 내용 -->\n\t</div>"


- 다음은 특강 이후에 추가적으로 알아낸 wikipedia에서 table을 긁어와 이를 histogram으로 그리는 방법입니다.

# table을 가져올 링크를 tar2에 저장합니다.
tar2 <- "https://en.wikipedia.org/wiki/List_of_countries_by_GDP_(nominal)_per_capita"
# 링크에서 필요한 테이블을 Xpath를 이용해 특정합니다. 이후 df에 저장합니다.
df <- read_html(tar2) %>%
  html_nodes(xpath = '//*[@id="mw-content-text"]/div/table/tbody/tr[2]/td[1]/table') %>%
  html_table(fill = T) %>% 
  as.data.frame()
# df의 구조 확인.
str(df)
## 'data.frame':    193 obs. of  3 variables:
##  $ Rank             : chr  "1" "2" "—" "3" ...
##  $ Country.Territory: chr  "Luxembourg" "Switzerland" "Macau" "Norway" ...
##  $ US.              : chr  "114,234" "82,950" "82,388" "81,695" ...
# 1인당 GDP 항목의 데이터가 character이고 숫자 사이에 쉼표가 들어가 있어 바로 numeric으로 바꿀 시에 오류가 있을 수 있음을 알 수 있습니다.
head(df$US.)
## [1] "114,234" "82,950"  "82,388"  "81,695"  "76,099"  "74,278"
# column명을 알기 쉽도록 변경하고, character로 되어있는 GDP 순위와 1인당 GDP column을 numeric으로 바꿉니다.
names(df) <- c('Rank.GDP','Country','US.dollar')
df$Rank.GDP <- as.numeric(df$Rank.GDP)
## Warning: 강제형변환에 의해 생성된 NA 입니다
# 데이터가 너무 많기에 상위 30위까지만 선택합니다.
df <- subset(df, df$Rank.GDP <= 30)
# 1인당 GDP 항목을 gsub 함수를 이용해 숫자 사이에 들어간 쉼표를 제거 후 numeric으로 바꿔줍니다.
df$US.dollar <- as.numeric(gsub(",", "", df$US.dollar))
df$Country <- as.factor(df$Country)
# 다시 확인해 봅니다.
str(df)
## 'data.frame':    30 obs. of  3 variables:
##  $ Rank.GDP : num  1 2 3 4 5 6 7 8 9 10 ...
##  $ Country  : Factor w/ 30 levels "Australia","Austria",..: 18 27 22 12 11 23 25 30 7 1 ...
##  $ US.dollar: num  114234 82950 81695 76099 74278 ...
head(df$US.dollar)
## [1] 114234  82950  81695  76099  74278  70780


- 이후 histogram을 그려봅니다.

df %>%
  ggplot(mapping = aes(x = reorder(Country, Rank.GDP), y = US.dollar)) +
  geom_histogram(stat = 'identity')
## Warning: Ignoring unknown parameters: binwidth, bins, pad


  • 남녀 경제 활동 참가율 분석 (해외)


1. 데이터 불러오기 및 데이터 정리

par <- read.csv('women_work.csv')
str(par)
## 'data.frame':    2000 obs. of  13 variables:
##  $ c1           : num  -0.436 0.352 1.077 1.021 -0.443 ...
##  $ c2           : num  -0.0969 0.3005 -1.596 -1.7105 0.3083 ...
##  $ u            : num  -0.218 0.176 0.539 0.511 -0.221 ...
##  $ v            : num  -0.3757 0.4612 -0.3762 -0.497 -0.0925 ...
##  $ county       : int  1 2 3 4 5 6 7 8 9 0 ...
##  $ age          : int  22 36 28 37 39 33 57 45 39 25 ...
##  $ education    : int  10 10 10 10 10 10 10 16 12 10 ...
##  $ married      : int  1 1 1 1 1 1 1 1 1 0 ...
##  $ children     : int  0 0 0 0 1 2 1 0 0 3 ...
##  $ select       : num  16.8 32.4 19.2 21.3 32 ...
##  $ wagefull     : num  12.8 20.3 23.1 24.5 16.1 ...
##  $ wage         : num  NA 20.3 NA NA 16.1 ...
##  $ participation: int  0 1 0 0 1 1 1 1 0 1 ...
par$married <- factor(par$married,
                      labels = c('single',
                                 'married'))
table(par$married)
## 
##  single married 
##     659    1341


* 참가율(%) 산출

## # A tibble: 2 x 3
##   participation     n percent
##           <int> <int>   <dbl>
## 1             0   657    32.8
## 2             1  1343    67.2


2. linear probaility model (linear regression), 선형회귀모델. age, education, married, children이 한 단위 늘었을 때, 경제활동 참가를 할 ’확률’이 얼마나 증가하는가?

## 
## Call:
## lm(formula = participation ~ age + education + married + children, 
##     data = par)
## 
## Residuals:
##     Min      1Q  Median      3Q     Max 
## -1.0703 -0.4142  0.1372  0.3437  0.8060 
## 
## Coefficients:
##                 Estimate Std. Error t value Pr(>|t|)    
## (Intercept)    -0.207323   0.054111  -3.831 0.000131 ***
## age             0.010255   0.001227   8.358  < 2e-16 ***
## education       0.018601   0.003250   5.724 1.20e-08 ***
## marriedmarried  0.111112   0.021948   5.063 4.52e-07 ***
## children        0.115308   0.006772  17.028  < 2e-16 ***
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
## 
## Residual standard error: 0.4199 on 1995 degrees of freedom
## Multiple R-squared:  0.2026, Adjusted R-squared:  0.201 
## F-statistic: 126.7 on 4 and 1995 DF,  p-value: < 2.2e-16


* 선형회귀분석한 값을 이용한 예측모형과 그래프 (결혼 여부에 따른 차이)


-> 예측에 사용하려 했으나 그래프의 범위가 0과 1 사이를 벗어나 예측이 불가능하다.

3. generalized linear model (apply logistic function)
* age, education, married, children이 한 단위 늘었을 때, ’single index’가 얼마나 증가하는가? 즉, 확률이 늘어나는가? 혹은 줄어드는가? 여부만 알 수 있다.

## 
## Call:
## glm(formula = participation ~ age + education + married + children, 
##     family = "binomial", data = par)
## 
## Deviance Residuals: 
##     Min       1Q   Median       3Q      Max  
## -2.6212  -0.9292   0.4614   0.8340   2.0455  
## 
## Coefficients:
##                 Estimate Std. Error z value Pr(>|z|)    
## (Intercept)    -4.159247   0.332040 -12.526  < 2e-16 ***
## age             0.057930   0.007221   8.022 1.04e-15 ***
## education       0.098251   0.018652   5.268 1.38e-07 ***
## marriedmarried  0.741777   0.126471   5.865 4.49e-09 ***
## children        0.764488   0.051529  14.836  < 2e-16 ***
## ---
## Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
## 
## (Dispersion parameter for binomial family taken to be 1)
## 
##     Null deviance: 2532.4  on 1999  degrees of freedom
## Residual deviance: 2055.8  on 1995  degrees of freedom
## AIC: 2065.8
## 
## Number of Fisher Scoring iterations: 5


-> age, education, married, children 이 한 단위 증가할 때, 경제활동참가율이 (어느 정도인지는 모르나) 증가한다.

* glm의 그래프


-> 모든 값이 0과 1 사이에 들어와 예측모형에 활용 할 수 있다.
* 일반적으로 경제학자들은 이 그래프의 추세선의 기울기, 머신러닝 분야에서는 이 모델을 활용한 예측에 관심이 있다.